목차 5
오픈AI의 코덱스나 앤트로픽의 클로드 메뉴에는 모델 이름과 함께 AI가 얼마나 생각할지 정하는 추론 수준이 있습니다. 가장 똑똑한 모델에 가장 높은 추론 수준을 고르면 AI의 답도 가장 좋을 것 같습니다.
그런데 막상 그렇게 골라 써 보면 AI의 답이 평소 설정으로 받던 답과 크게 달라 보이지 않을 때가 있습니다. 답을 기다리는 시간은 길어지고 사용량은 금방 찹니다. 그럴 때는 모델을 바꿔야 할까요? 추론 수준을 올려야 할까요? 이미 가장 높은 추론 수준을 골라 두었다면 더 올릴 곳도 없고요.
모델과 추론 수준을 성능 하나로 묶어서 보면 이 질문에 답하기 어렵다고 생각합니다. 모델은 어떤 AI가 일할지를 정하고 추론 수준은 그 AI가 답하기 전에 얼마나 오래 생각할지를 정하니까요. 이 글에서는 클로드와 코덱스의 모델과 추론 수준을 2026년 11월 공식 안내를 기준으로 표에 담아 보려고 합니다. 그리고 답이 아쉬울 때 더 똑똑한 모델이 필요한지 같은 모델에게 시간을 더 주면 되는지 아니면 요청을 고쳐야 하는지 구분하며 모델과 추론 수준을 고르는 순서를 정리해 보겠습니다.
모델과 추론 수준은 무엇이 다를까요?#
모델과 추론 수준은 메뉴에 나란히 붙어 있어서 한 세트처럼 보이지만 따로 고르는 설정입니다. 모델과 추론 수준의 특징은 다음과 같습니다.
- 모델: 모델마다 해낼 수 있는 일의 수준과 속도, 쓰는 사용량이 다릅니다.
- 추론 수준(effort, reasoning effort): 같은 모델이 답하기 전에 얼마나 오래 고민하고 확인할지 정합니다. 추론 수준을 높일수록 답이 꼼꼼해지는 대신 답이 나오기까지 오래 걸리고 사용량을 더 씁니다.
모델과 추론 수준을 고르는 일은 사람에게 일을 부탁하는 상황과 비슷합니다. '이 일을 누구한테 맡길까'가 모델이라면 추론 수준은 '그 사람한테 시간을 얼마나 줄까'입니다. 모델을 바꾸면 일하는 사람이 바뀌고 추론 수준을 올리면 같은 사람이 더 오래 고민하는 거죠. 물론 무엇을 해 달라는지가 요청에 빠져 있으면 누구에게 얼마나 시간을 줘도 원하는 답이 나오기 어렵습니다.
그럼 AI에게 시간을 더 주면 실제로 무엇이 달라질까요? 앤트로픽이 Opus 5.5(2026년 9월 공개)와 이전 모델 Fable 5.1로 테스트해 보니 추론 수준을 높였을 때 모델이 더 많은 경우를 살펴보고 자기 결과도 더 자주 확인했다고 합니다. 반대로 추론 수준을 낮췄을 때는 일단 시작해 볼 결과물이 더 빨리 나왔고요. 그러니 결과를 바로 보고 다시 요청할 일이라면 답을 오래 기다릴 이유가 없고 AI가 혼자 오래 할 일이라면 시간을 넉넉히 주는 편이 나을 것 같습니다.
그렇다면 답이 아쉬울 때는 무엇부터 바꿔 봐야 할까요? 같은 모델에 추론 수준만 올려 보는 쪽을 먼저 해 보는 게 좋다고 생각합니다. 추론 수준은 같은 모델에서 시간 하나만 바꾸는 일이지만 모델을 바꾸면 능력과 속도와 사용량이 통째로 달라져서 답이 나아져도 무엇 덕분인지 알기 어렵거든요. 앤트로픽도 모델을 바꾸기보다 추론 수준을 바꾸는 쪽이 나은 경우가 많다고 설명합니다.
처음부터 가장 높은 추론 수준을 골라 두면 답이 아쉬울 때 더 올려 볼 수가 없습니다. 그래서 가장 높은 추론 수준보다는 앤트로픽과 오픈AI가 각각 안내하는 시작 단계부터 쓰는 쪽을 추천합니다. 시작 단계와 추론 수준을 바꾸는 메뉴는 서비스마다 다르니 클로드와 코덱스를 차례로 보겠습니다.
클로드의 모델과 추론 수준 (2026년 11월 기준)#
클로드는 클로드 앱(claude.ai와 데스크톱, 휴대폰 앱)과 클로드 코드에서 같은 모델을 쓰고 추론 수준도 low부터 max까지 같은 단계로 고릅니다(앱과 터미널의 차이는 AI는 어디서 쓸까에 정리해 두었습니다). 클로드를 앱에서 쓰든 터미널에서 쓰든 모델 종류는 아래 표 하나만 보면 된다는 뜻이죠.
| 모델 | 특징 | 추천 작업 | 클로드 코드 기본 추론 수준 |
|---|---|---|---|
| Claude Fable 5.2 | 앤트로픽이 누구나 쓸 수 있게 공개한 모델 가운데 가장 똑똑한 모델 | 몇 시간씩 이어지는 작업, 여러 단계의 깊은 조사, 완성된 문서나 표나 장표까지 이어지는 분석 | medium |
| Claude Opus 5.5 | 오래 이어지는 복잡한 작업과 지식 업무를 위한 모델. 앤트로픽이 대부분의 작업에 먼저 추천하는 모델 | 오래 걸리는 코딩, 대규모 수정, 이미지가 많은 작업 | medium |
| Claude Sonnet 5.5 | 속도와 능력의 균형을 맞춘 모델 | 매일 하는 코딩, 데이터 분석, 콘텐츠 만들기 | medium |
| Claude Haiku 5.5 | 가장 빠르고 값이 낮은 모델 | 실시간으로 답해야 하는 일, 양이 많은 처리, 하위 작업 | medium |
클로드 모델 표의 오른쪽 칸에 적힌 기본 추론 수준은 조금 의외로 보입니다. 똑똑한 모델이면 높은 추론 수준에서 시작할 것 같은데 가장 똑똑한 Fable 5.2도 클로드 코드에서는 medium에서 시작합니다. 앤트로픽은 추론 단계를 모델마다 따로 맞춘다고 설명합니다. 같은 medium이라도 모델마다 생각하는 양이 다르다는 말인데 이 차이는 코덱스 표에서 더 분명하게 드러납니다.
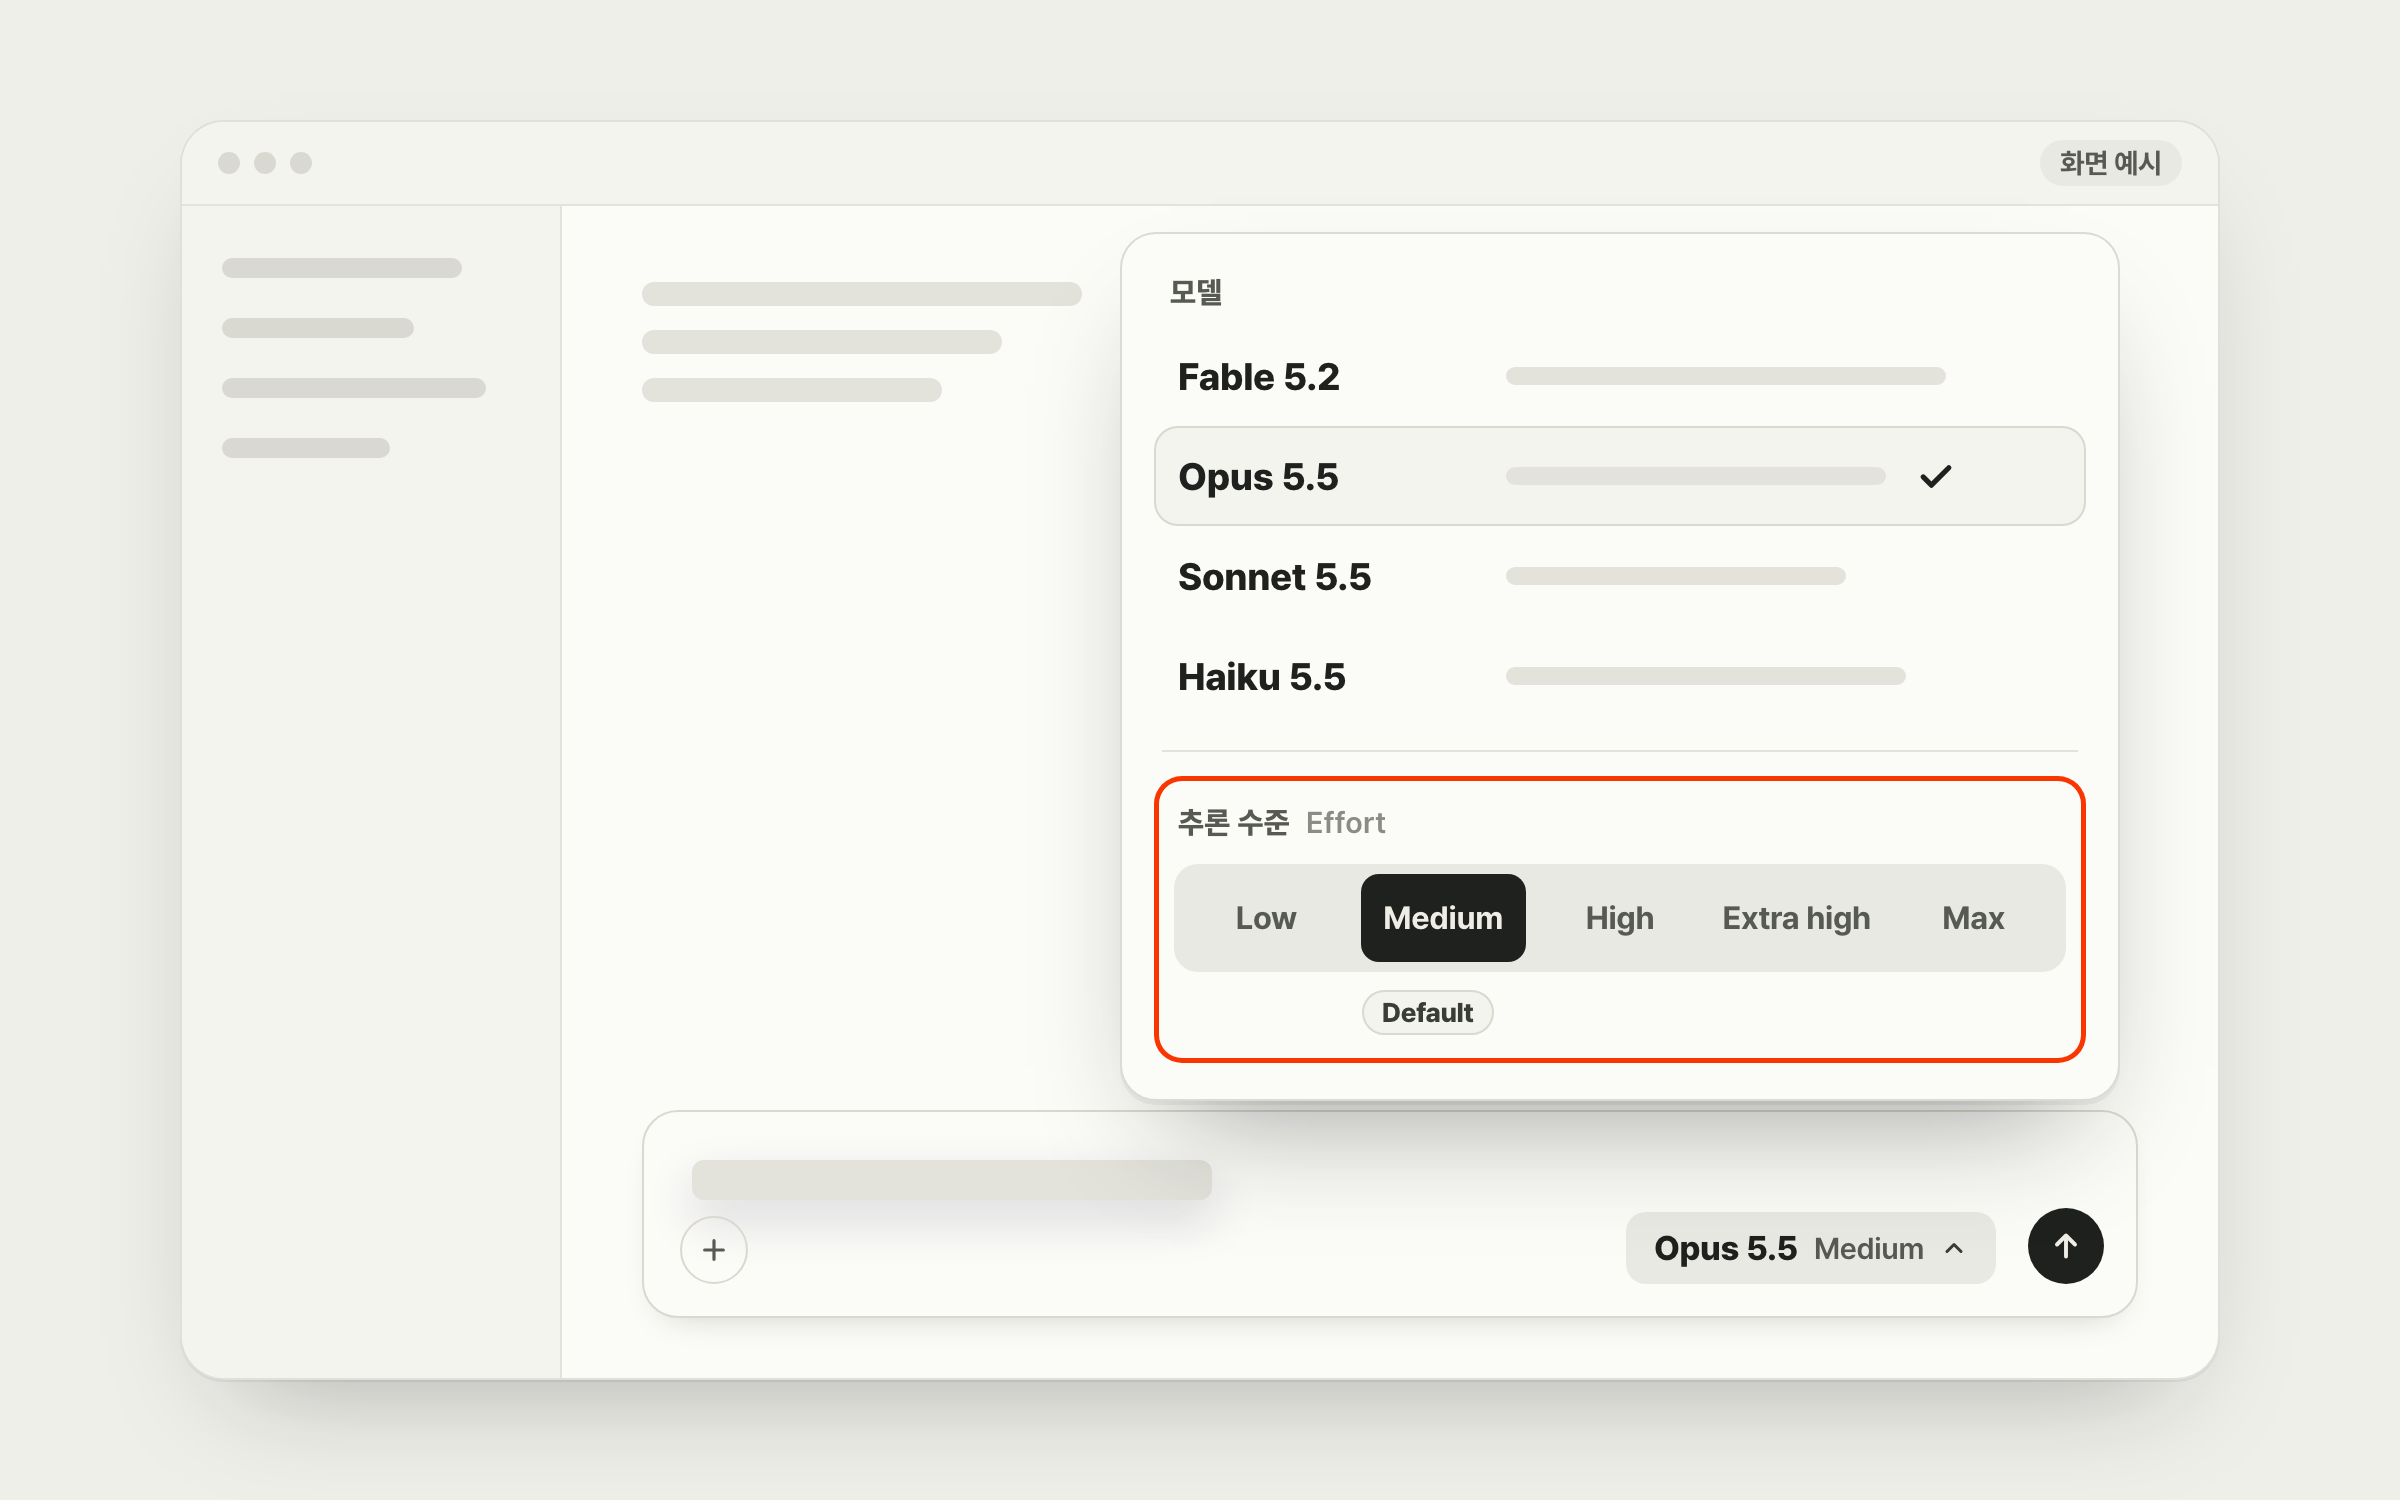
클로드 코드에서는 모델 표의 기본 추론 수준이 곧 시작 단계입니다. 앱 메뉴에서는 모델마다 권장 단계에 [Default] 표시가 붙어 있으니 [Default] 표시가 붙은 단계에서 시작해 답이 아쉬울 때 추론 수준을 한 단계씩 올리면 됩니다.
추론 수준을 어디까지 올릴지는 업무에 따라 다르겠죠. 아래 추론 수준 표는 처음 시작할 추론 수준을 정하는 표라기보다 시작 단계에서 올리다가 어디쯤에서 멈출지 볼 때 쓰면 좋을 것 같습니다.
| 추론 수준(앱 표기) | 추천 작업 |
|---|---|
| low(Low) | 결과를 하나씩 확인하며 주고받는 빠른 작업. 아이디어 내기, 첫 스케치, 작은 수정 |
| medium(Medium) | 범위가 분명한 매일의 작업. 반복 업무에서 사용량을 아끼고 싶을 때 |
| high(High) | 품질과 속도의 균형이 가장 좋은 단계. 확인이 중요하거나 예외가 많을 법한 일 |
| xhigh(Extra high) | 오래 걸리는 코딩과 에이전트 작업. max만큼 사용량을 쓰지 않으면서 high보다 깊게 생각함 |
| max(Max) | 가장 깊은 추론이 필요한 어려운 문제. 생각만 길어지고 효과는 줄어들 수 있어 앤트로픽은 먼저 써 보고 정하라고 안내함 |
추론 수준 표를 보고 추론 수준을 올리기로 했다면 바꾸는 곳은 앱과 클로드 코드가 다릅니다.
- 클로드 앱: 전송 버튼 옆의 모델 이름을 누르면 모델을 선택할 수 있고 [Effort]에서 추론 수준을 선택합니다. 대화 중에 언제든 모델과 추론 수준을 바꿀 수 있고 바꾼 설정은 다음 답부터 적용됩니다.
- 클로드 코드:
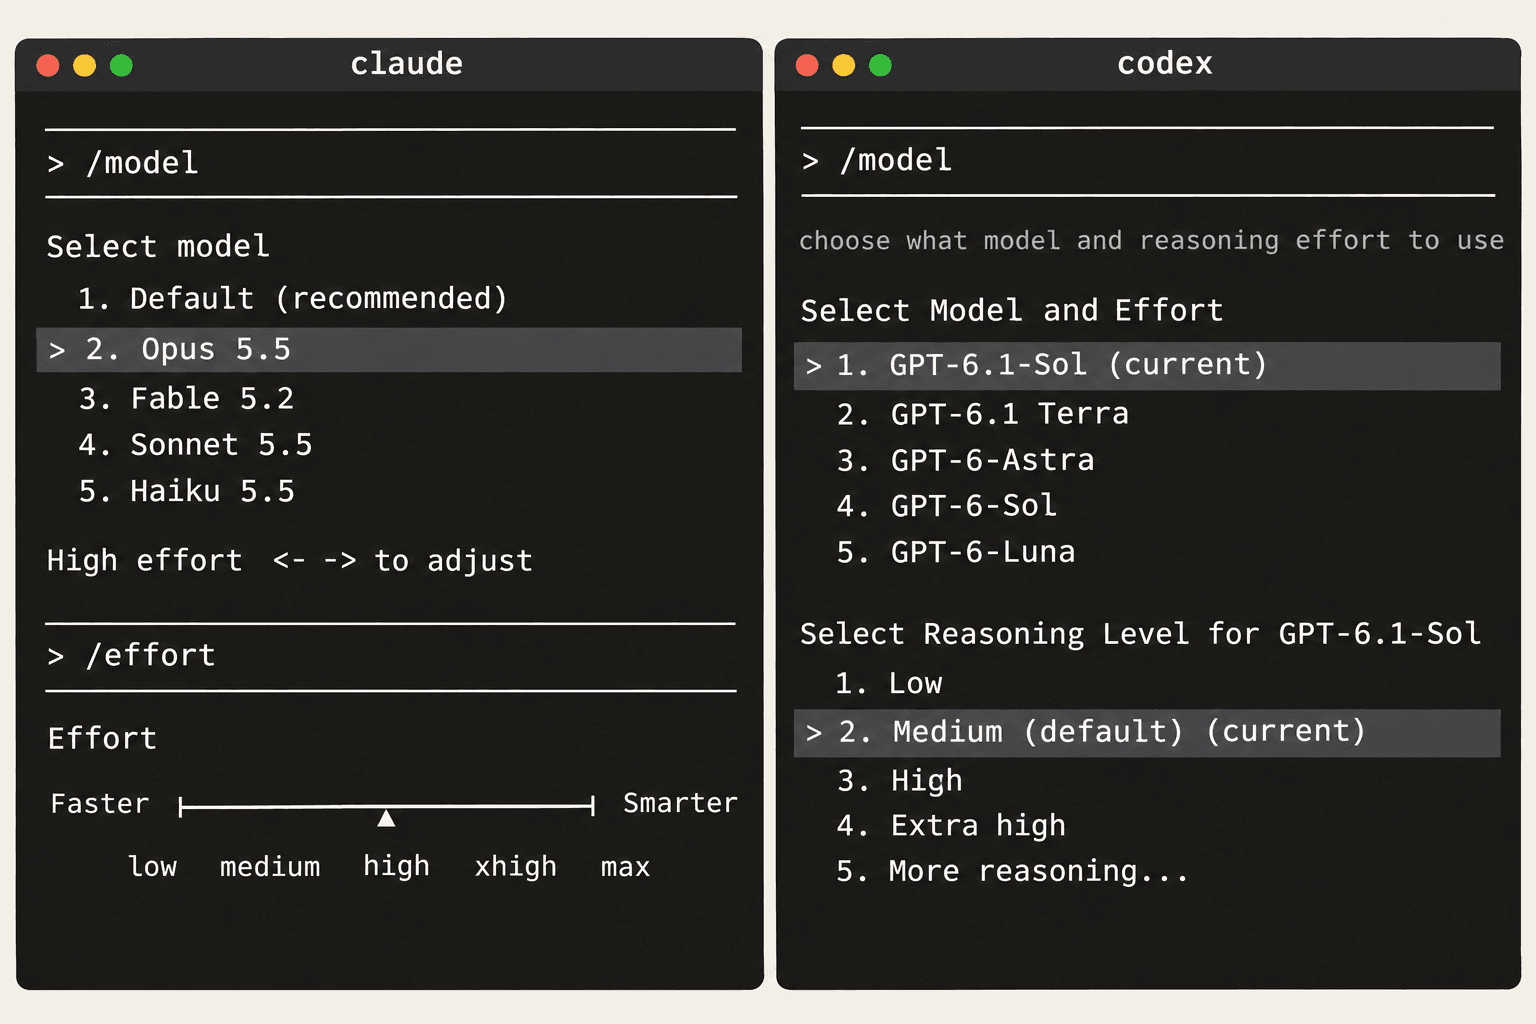
/model로 모델을 선택하면서 좌우 방향키로 추론 수준을 함께 조절하거나/effort로 추론 수준만 바꿉니다.
앱 메뉴에는 [Effort] 말고 생각을 켜는 [Thinking] 설정이 따로 있습니다. [Thinking]을 끄면 답이 더 빨라질 것 같지만 클로드 모델 표에 있는 모델은 모두 [Thinking]을 끌 수 없습니다. AI가 생각할 시간을 줄이고 싶을 때도 바꿀 곳은 추론 수준입니다.
코덱스의 모델과 추론 수준 (2026년 11월 기준)#
코덱스는 챗GPT 데스크톱 앱과 코덱스 CLI에서 쓸 수 있는데 모델과 추론 수준을 선택하는 곳부터 꽤 다릅니다.
- 챗GPT 데스크톱 앱: 입력창 아래의 조절 막대(Power)에서 모델과 추론 수준을 선택합니다. 막대를 [Smarter] 쪽으로 옮기면 코덱스가 더 깊게 생각하고 [Faster] 쪽으로 옮기면 코덱스가 더 빠르게 답하고 사용량이 적습니다.
- 코덱스 CLI: 세션 중에
/model로 모델과 추론 수준을 선택합니다. Max와 Ultra는 모델을 고른 뒤 [More reasoning…]에서 보입니다.
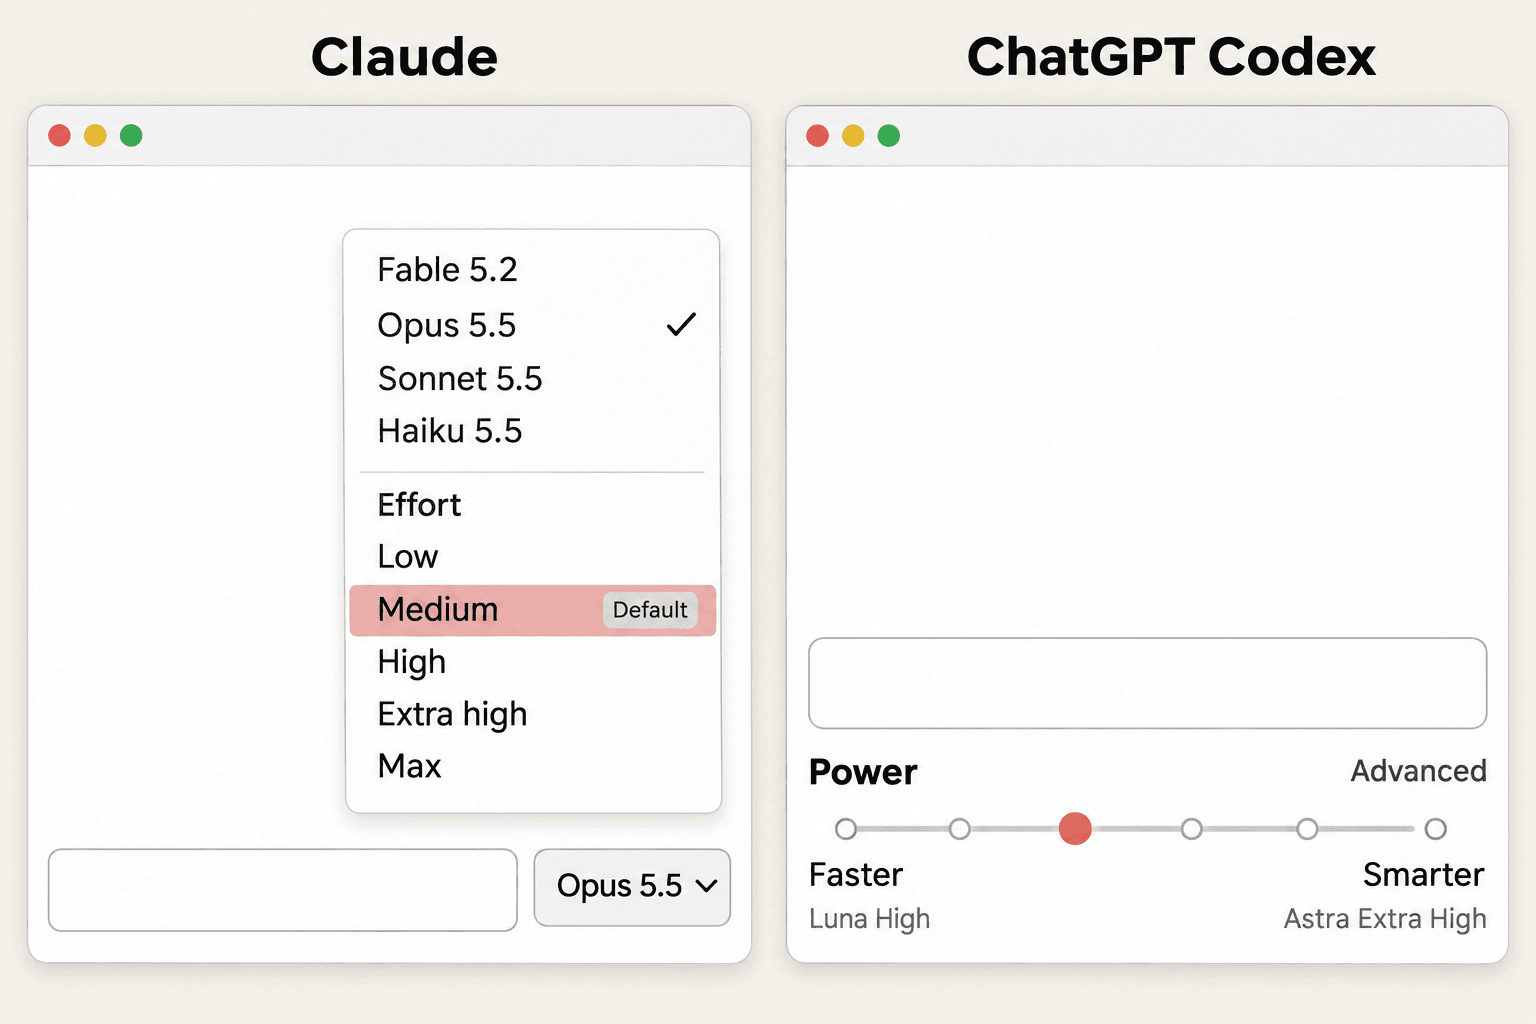
챗GPT 앱의 Power 막대는 코덱스가 더 빠르게 답할지 더 깊게 생각할지를 한 번에 정할 수 있어서 편합니다. 그런데 막대의 칸마다 모델과 추론 수준이 묶여 있어서 막대를 한 칸만 옮겨도 모델과 추론 수준이 같이 바뀝니다. 오픈AI가 예로 든 칸도 Luna High나 Astra Extra High처럼 모델 이름과 단계가 붙어 있습니다. Power 막대의 칸은 요금제와 화면, 회사 계정 설정에 따라 다를 수 있습니다.
Power 막대를 옮긴 뒤에 답이 좋아졌다면 '모델이 바뀐 덕분일까 더 오래 생각한 덕분일까?' 하는 물음이 남습니다. Power 막대만 봐서는 알 수 없죠. 하나씩 바꿔 보고 싶다면 막대 옆의 [Advanced]를 열어 모델과 추론 수준을 따로 선택하면 됩니다.
모델과 추론 수준을 따로 고른다면 추론 수준은 어느 단계에서 시작하면 될까요? 오픈AI가 모델마다 추천하는 시작 단계는 다음과 같습니다.
| 모델 | 특징 | 추천 작업 | 오픈AI 권장 시작 단계 |
|---|---|---|---|
| GPT-6 Astra | 오픈AI의 가장 똑똑한 모델. 깊은 추론과 컴퓨터 사용에 강하고 판단력이 좋음 | 코드와 앱과 조사를 오가는 가장 어려운 작업 | Light(CLI에서는 low) |
| GPT-6.1 Sol | Astra에 가까운 성능을 Astra보다 낮은 비용으로 내는 모델 | 코드, 앱, 문서를 오가며 반복되고 오래 걸리는 작업 | 쓰는 화면의 기본값 |
| GPT-6.1 Terra | 빠르고 효율적인 모델 | 분명한 글쓰기, 차트와 화면 읽기, 앱 안에서 하는 작업 | 따로 안내 없음 |
| GPT-6 Luna | 가장 효율적인 모델 | 요약, 추출, 분류처럼 좋은 결과가 무엇인지 분명하고 양이 많은 작업 | High |
코덱스 모델 표에서 눈에 띄는 건 시작 단계입니다. 오픈AI는 가장 똑똑한 Astra는 가장 낮은 Light에서 시작하라고 하고 가장 효율적인 Luna는 High에서 시작하라고 합니다. 똑똑한 모델일수록 높은 추론 수준에서 시작할 것 같은데 거꾸로 적어 둔 것 같죠.
Astra가 가장 낮은 Light에서 시작하는 이유를 오픈AI가 밝히지는 않았습니다. 앞에서 본 앤트로픽의 설명처럼 같은 이름의 추론 수준이라도 모델마다 생각하는 양이 다르기 때문으로 보입니다. Astra 같은 똑똑한 모델은 Light에서도 충분히 생각하고 Luna 같은 효율적인 모델은 High쯤은 줘야 그만큼 생각하는 게 아닐까 싶습니다. 그러니 추론 수준의 이름만 보고 생각할 시간이 충분한지 판단하기는 어렵습니다.
아래 표는 오픈AI가 추론 수준마다 권장하는 작업입니다. 이 표도 클로드의 추론 수준 표처럼 코덱스 모델 표의 시작 단계에서 추론 수준을 올리다가 어디쯤에서 멈출지 볼 때 쓰시면 됩니다.
| 추론 수준(앱 / CLI) | 추천 작업 |
|---|---|
| Light / low | 범위가 분명한 빠른 작업 |
| Medium / medium | 계획이 조금 더 필요한 일. 속도와 깊이의 균형 |
| High, Extra High / high, xhigh | 여러 단계와 자료를 거치고 고려할 조건이 많은 어려운 일 |
| Max / max | 가장 어려운 문제 하나를 더 오래 생각하게 할 때. 속도와 사용량보다 깊이가 중요할 때 |
| Ultra / ultra | 큰 일을 하위 에이전트(subagent) 여럿에게 나눠 동시에 처리하게 할 때. GPT-6 Luna에는 없는 단계 |
추론 수준 표 맨 아래의 Ultra는 이름만 보면 Max보다 더 오래 생각하는 단계 같지만 성격이 다릅니다. 앞의 사람 비유로 말하면 Ultra는 한 사람에게 시간을 더 주는 게 아니라 여러 사람에게 일을 나눠 주는 쪽입니다.
그래서 Ultra는 업무를 여러 조각으로 나눠 동시에 해도 될 때만 고르면 됩니다.
그럼 이렇게 많은 모델 가운데 지금 하려는 업무에는 어떤 모델과 추론 수준을 선택하면 될까요?
가장 똑똑한 모델이 정답일까요? 업무에 맞는 AI 모델과 추론 수준 고르는 법#
저는 모델은 업무의 종류로 정하고 추론 수준은 AI의 답을 보면서 조절하면 된다고 생각합니다.
매주 쓰는 보고서 문장 몇 줄을 다듬으려고 가장 똑똑한 모델의 답을 기다리고 사용량까지 써야 한다면 좀 아깝지 않을까요? 가장 똑똑한 모델은 가장 어렵고 오래 걸리는 업무를 위해 만든 모델이니까요. 매일 하는 업무라면 더 빠르고 사용량이 적은 모델로도 충분할 때가 많습니다.
모델을 고를 때는 그래서 모델 이름보다 AI에게 시킬 업무가 얼마나 어렵고 오래 걸리는지를 먼저 보면 좋겠습니다. 클로드와 코덱스의 모델은 이름이 달라서 비교하기 어렵지만 앤트로픽과 오픈AI가 적은 용도 설명을 보면 모델이 하는 업무는 꽤 비슷하게 나뉘는 것 같습니다. 앤트로픽과 오픈AI가 서로의 모델을 같은 급이라고 안내한 것은 아니고 제가 용도 설명을 보고 비교해 본 것이니 참고로만 봐 주세요.
| 작업 유형 | 클로드 모델 | 코덱스 모델 |
|---|---|---|
| 가장 어렵고 오래 걸리는 일 | Fable 5.2 | GPT-6 Astra |
| 시간이 걸리는 복잡한 일 | Opus 5.5 | GPT-6.1 Sol |
| 매일 하는 일을 빠르게 | Sonnet 5.5 | GPT-6.1 Terra |
| 양이 많은 반복 작업 | Haiku 5.5 | GPT-6 Luna |
그럼 추론 수준은 어떨까요? 처음부터 추론 수준을 가장 높은 단계로 해 두면 마음은 편할 것 같습니다. 오래 걸려도 더 좋은 답이 나올 테니까요. 꼭 그렇지는 않습니다. 가장 높은 추론 수준은 효과 자체가 줄어들 수 있거든요.
오픈AI는 대부분의 작업에 추론 수준 Max나 Ultra가 필요하지 않다고 말합니다. 앤트로픽도 추론 수준 max는 생각만 길어지고 효과는 줄어들 수 있다고 설명하고요. 답은 비슷한데 시간과 사용량만 늘어나는 일은 이 때문일 것 같습니다. 이미 가장 높은 추론 수준을 쓰고 있다면 시작 단계로 내려서 같은 업무를 다시 시켜 볼 만합니다. 시작 단계의 답이 가장 높은 추론 수준의 답과 비슷하다면 시간과 사용량만 더 쓰고 있었던 셈이니까요.
그렇다고 모든 업무에서 추론 수준을 시작 단계에 둘 필요는 없습니다. 추론 수준을 시작 단계보다 올릴지는 '바로 보고 고칠 일인가, AI가 혼자 한참 생각해야 할 일인가'로 나눠 보면 될 것 같습니다. 오픈AI가 든 예로 보면 짧은 메일을 고쳐 쓰는 일은 낮은 추론 수준으로 충분하고 조건이 서로 부딪히는 제안서 여러 개를 비교하는 일은 높은 추론 수준을 고를 만합니다. 메일은 바로 보고 다시 고칠 일이고 제안서 비교는 AI가 혼자 오래 생각해야 할 일이기 때문입니다. AI가 혼자 오래 일하는 작업이라면 앤트로픽과 오픈AI 모두 Extra high를 권장합니다. 오픈AI가 시작 단계를 따로 안내하지 않은 GPT-6.1 Terra는 화면에 처음 정해진 추론 수준에서 시작하면 됩니다.
그렇게 시작한 뒤에 추론 수준을 올려 봤는데도 답이 아쉬울 때가 가장 고민되는 순간입니다. 추론 수준을 한 단계 올렸더니 답이 더 꼼꼼해졌다면 부족했던 건 생각할 시간이었다고 볼 수 있습니다. 그런데 추론 수준을 몇 단계 올려도 답이 그대로라면 생각할 시간이 모자라서 생긴 문제가 아닐 수 있습니다. 사람에게 일을 부탁할 때도 무엇을 해 달라는지가 빠져 있으면 시간을 아무리 줘도 원하는 결과가 나오지 않거든요. 그래서 모델을 바꾸기 전에 요청부터 다시 보시기를 권장 드립니다. 추론 수준도 충분히 올렸고 요청도 분명한데 답이 아쉽다면 그때가 더 똑똑한 모델이 필요한 때입니다.
모델을 바꿨다면 쓰던 추론 수준 대신 새 모델의 시작 단계로 돌아가는 쪽을 추천합니다. 쓰던 모델의 High가 새 모델에서도 같은 양을 생각하는 High는 아니니까요. 오픈AI도 모델 세대가 바뀌면 같은 이름의 추론 수준이 똑같지 않다고 설명합니다.
모델은 메뉴를 건드리지 않아도 바뀌어 있을 때가 있습니다. 코덱스에서 쓰던 GPT-5.5는 2026년 10월 14일부터 챗GPT 계정으로는 쓸 수 없게 됐고 요금제에 따라 GPT-6.1 Sol이나 GPT-6 Luna를 쓰게 됩니다. 클로드 코드에서도 Pro와 Max 요금제에서 골라 둔 Fable 5.1은 Fable 5.2가 나오면서 5.2로 바뀌었습니다. 메뉴의 모델 이름이 달라졌다면 그 모델의 시작 단계부터 다시 보면 됩니다.
시작 단계로 돌아간 뒤 어디까지 올릴지는 자주 하는 업무로 비교해 보면 빨리 정할 수 있습니다. 매주 만드는 보고서처럼 자주 하는 업무를 골라 추론 수준만 바꿔 몇 번 돌려 보면 그 업무에 맞는 추론 수준이 보이기 시작할 겁니다. 앤트로픽과 오픈AI도 잘 아는 일과 실제 자료로 테스트해 보라고 안내합니다.
AI 모델과 추론 수준 고르는 순서 정리#
업무의 종류를 보는 것부터 모델을 바꾸는 것까지 순서로 정리하면 다음과 같습니다.
- 업무의 종류로 모델을 고릅니다. 작업 유형 표를 기준으로 하되 요금제에 따라 쓸 수 있는 모델이 다를 수 있습니다.
- 추론 수준은 시작 단계부터 씁니다. 클로드는 앱의 [Default] 표시가 붙은 단계나 클로드 코드의 기본값을 그대로 쓰고 코덱스는 코덱스 모델 표의 시작 단계를 씁니다. 시작 단계 안내가 없는 모델은 화면에 처음 정해진 추론 수준을 그대로 둡니다. 결과를 바로 보고 고칠 일은 시작 단계나 그보다 낮은 단계로 충분하고 AI가 혼자 오래 생각해야 할 일은 Extra high에서 시작해 볼 만합니다.
- 결과가 아쉬우면 추론 수준을 한 단계씩 올립니다. 답이 충분히 꼼꼼해지면 추론 수준을 더 올리지 않습니다.
- 추론 수준을 몇 단계 올려도 답이 그대로라면 요청부터 다시 보고 그래도 답이 아쉬울 때 모델을 바꿉니다. 모델을 바꿨다면 쓰던 추론 수준 대신 새 모델의 시작 단계로 돌아갑니다.
- 자주 하는 업무는 같은 과제로 추론 수준만 바꿔 비교해 그 업무에 쓸 추론 수준을 정합니다.
